Blog · 18 OCT 2026 · Laboratorio
ComfyUI y RunPod: guía para crear contenido con GPU en la nube
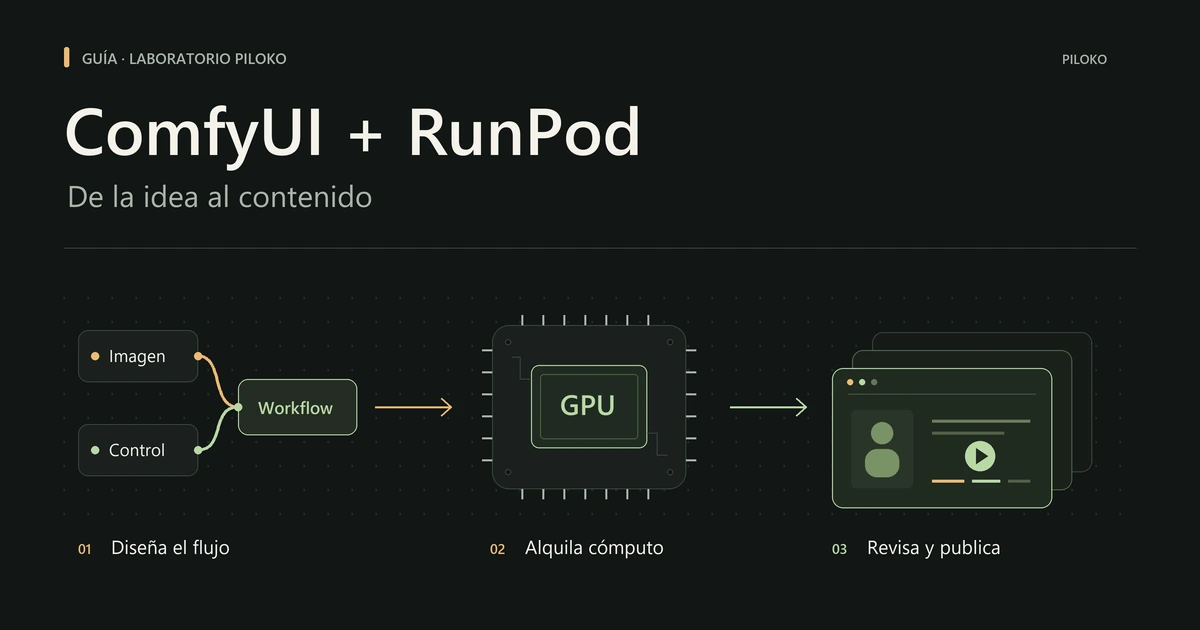
Guía de producción · Laboratorio Piloko
Crear imágenes y video con ComfyUI no exige comprar una GPU. Podemos alquilarla por decenas de centavos de dólar por hora, preparar una tanda y apagarla al terminar. Lo que cuesta de verdad depende de cuántos intentos se convierten en contenido que sí usaríamos.
Esta guía parte del trabajo con Fer, ComfyUI y Blender y de las 13 pruebas de video con LTX en RunPod. Explica cómo organizar una producción pequeña, dónde siguen apareciendo fallas y qué opciones hay para rentar cómputo o pagar por generación.
Publicado el 18 de octubre de 2026 · Precios consultados en esa fecha · Importes en dólares estadounidenses (USD).
ComfyUI, el modelo y la GPU hacen trabajos distintos
ComfyUI organiza el proceso. Conecta instrucciones, imágenes, modelos y salidas mediante nodos. El modelo interpreta las entradas: Z-Image, Wan y LTX no son intercambiables ni tienen los mismos controles. La GPU ejecuta el trabajo; RunPod y Vast.ai permiten alquilar una máquina para hacerlo.
Comfy Cloud ofrece el editor administrado. Las API de fal o Replicate permiten pedir resultados mediante una interfaz de programación, sin instalar tú el modelo. Son rutas distintas hacia la generación, con distintos grados de control y distintas unidades de cobro.
En nuestro caso, Z-Image Turbo con el LoRA de Fer creó la referencia de identidad; Wan Animate 2 recibió después esa imagen y un video conductor. El LoRA de Z-Image no se enchufó directamente a Wan. La serie roja y azul más reciente se animó con LTX-2.3 distilled FP8, ComfyUI y una A40 en RunPod. Identificar el modelo de cada prueba evita atribuir a la nube diferencias que vienen de otra receta.
Un flujo de trabajo para crear contenido sin dejar la GPU esperando
- Define la entrega antes de encender la máquina. Elige formato, duración, personaje y una acción principal. Escribe qué aceptarías: rostro estable, objeto reconocible, encuadre útil y un final que permita cortar. Una toma de seis segundos con una sola acción es un piloto más manejable que una historia con varios cambios de plano.
- Elige el modelo y una plantilla compatible. Revisa que coincidan el modelo, su codificador de texto, el VAE y los nodos necesarios. El VAE convierte entre imagen y la representación interna del modelo. Empieza por una plantilla oficial que puedas abrir completa; guarda una copia antes de modificarla. La guía oficial de Wan 2.2 ofrece flujos distintos para 5B y 14B: no conviene mezclar sus piezas al azar.
- Aprueba la imagen inicial. Revisa manos, ropa, rostro, objetos y espacio para el movimiento. Si una etiqueta o una cara ya está mal en la referencia, animarla añade otra capa de corrección. Guarda esa entrada junto al prompt.
- Prepara el entorno y el presupuesto. En RunPod, selecciona una GPU con memoria suficiente para el flujo y revisa el precio completo del despliegue. Usa una plantilla de ComfyUI cuya procedencia y dependencias puedas revisar. Decide dónde quedarán modelos y resultados, carga los archivos y comprueba que el grafo abre sin nodos faltantes. Deja listo el trabajo antes de mantener cómputo encendido durante una sesión de escritura.
- Ejecuta un piloto corto. Usa la resolución y duración bajas que admita esa plantilla. Ejecuta una muestra, descarga el archivo y comprueba que se abre. Si aparece falta de memoria, reduce primero resolución o fotogramas dentro de los límites del modelo; después considera descarga a RAM, cuantización compatible o más VRAM. No cambies todo a la vez.
- Itera con un registro. Anota versión del flujo, modelos, semilla, resolución, fotogramas, pasos y qué cambiaste. Mantén una variable fija mientras pruebas otra. La semilla sirve para rastrear la toma; no garantiza reproducción idéntica entre versiones y equipos.
- Revisa y edita. Ve el clip completo, no sólo su miniatura. Detén la imagen al inicio, en un contacto o giro y al final. Separa “generado” de “aprobado”. Une tomas, corrige color, añade sonido y títulos en edición cuando ese control sea más preciso que volver a generar toda la escena.
- Respalda y cierra la sesión. Descarga entradas, resultados, prompts y workflow JSON; abre una copia fuera de la máquina alquilada. Detén el cómputo desde el panel y comprueba su estado. Revisa también los volúmenes que conservas: el almacenamiento persistente puede seguir costando aunque no generes nada.
Una instrucción inicial podría ser la siguiente. Es un ejemplo propuesto para practicar, no el prompt de un resultado ya aprobado:
Plano medio de un personaje adulto sentado frente a una mesa. Mira una taza y sonríe suavemente. La taza permanece sobre la mesa. Cámara fija, una sola toma continua, luz constante. Conservar rostro, ropa, fondo y proporciones. Sin cortes ni movimientos de cámara.
Primero aprobaría esta acción sencilla. Después probaría tomar la taza, que introduce contacto entre dedos y objeto. Cada dificultad nueva necesita su propia revisión.
Las limitaciones que ya encontramos
Identidad y continuidad. Cambiar el modelo base alteró a Fer en los ensayos históricos. Prolongar clips usando su último fotograma tampoco elimina los saltos de estilo. En una prueba anterior de historias de quince segundos sólo se completó un piloto, y se descartó: preparar siete historias no significó terminar siete videos.
Manos, objetos y contacto. En la tanda de LTX la cerámica cambia mientras se manipula; en otra escena un libro se deforma al cerrarse. La acción puede entenderse y aun así fallar justo en el detalle protagonista. Un prompt más largo no demuestra que esos errores desaparezcan.
Cámara y geometría. Pedir una órbita de 360 grados produce una intención visual. Con un fondo neutro, nuestro clip no permite confirmar si gira la cámara o el personaje; tampoco entrega una malla 3D. Para repetir una trayectoria exacta o iluminar desde cualquier ángulo necesitamos construir esa escena.
Luz. El movimiento del maniquí de Blender sí sirvió como guía, pero sus focos no se trasladaron con fidelidad. La alternativa de relieve animado 2.5D permitió comparar cuatro luces en Blender; conservó iluminación en la textura y no se convirtió en una reconstrucción completa.
Memoria y entorno. La VRAM necesaria depende del modelo, duración, resolución y optimizaciones. La documentación de Comfy señala que Wan 2.2 5B puede ajustarse a 8 GB con descarga nativa a memoria del sistema; eso no significa que cualquier flujo de video quepa ahí o sea rápido. En Cloud, además, no se pueden instalar libremente nodos personalizados: hay que trabajar con los disponibles. En un entorno propio ganamos control y asumimos su mantenimiento.
Lo que todavía no medimos: no tenemos una factura desglosada que permita calcular el costo por clip aprobado de esta serie. Los trece videos conservados son evidencia visual de un experimento, no un benchmark de precio ni una comparación controlada entre proveedores.
Dónde alquilar GPU o pagar por inferencia
“Inferencia” es ejecutar un modelo para producir una salida. Puedes pagar por tener la máquina encendida, por tiempo de un trabajador, por créditos o por el resultado. Las cifras siguientes tienen unidades distintas. Son ejemplos públicos consultados el 18 de octubre de 2026, sujetos a configuración y disponibilidad; comprueba la cotización antes de arrancar.
| Servicio | Ejemplo de tarifa en USD | Cuándo lo consideraría |
|---|---|---|
| RunPod Pods Máquina GPU | A5000, 24 GB: US$0.27/h. A40, 48 GB: US$0.59/h. Catálogo oficial | ComfyUI con modelos y nodos propios, por sesiones y tandas. Hay que preparar el entorno y apagar el cómputo al acabar. |
| Vast.ai Mercado de GPU | Variable por oferta; revisar GPU, disco y transferencia juntos. Precios y mercado | Si puedes comparar proveedores y condiciones. Las ofertas interrumpibles exigen que el trabajo pueda recuperarse. |
| Comfy Cloud Editor administrado | Standard: US$20/mes. Creator: US$35/mes. Planes mensuales | Para producir sin administrar una máquina, dentro de los modelos, nodos y créditos de cada plan. |
| RunPod Serverless Trabajadores por API | Grupo de 24 GB: equivalente publicado de US$0.69/h de trabajador, facturado por segundos. Tarifa Serverless | Automatizar un flujo ya probado. Requiere prepararlo para API; incluye tiempo de arranque, ejecución y espera antes de apagarse. |
| fal API por resultado | Z-Image Turbo: US$0.005/megapíxel. Kling 2.5 Turbo Pro I2V: US$0.07/segundo de video. Precios por modelo | Pedir imágenes o video sin instalar el modelo. Los segundos de video son duración de salida, no segundos de GPU. |
| Replicate API de modelos | FLUX.1 schnell: US$0.003/imagen (US$3 por mil). Otros modelos cobran tiempo de hardware. Tarifas oficiales | Probar o integrar modelos con poco mantenimiento. Confirmar en cada ficha si cobra por resultado o por ejecución. |
En Vast.ai, el almacenamiento continúa al detener una instancia y la transferencia depende del proveedor. En RunPod Pods, el cómputo se factura por segundo y el almacenamiento retenido se cobra por separado; su documentación indica que no cobra entrada ni salida de datos. No elijas una GPU sólo por memoria o precio: prueba el flujo que vas a usar.
En Comfy Cloud editar el grafo no consume tiempo GPU; ejecutarlo consume créditos. Standard y Creator limitan cada ejecución a treinta minutos; Pro, a una hora. Importar modelos y LoRAs requiere un plan compatible. Los precios anuales equivalentes más bajos implican pagar el año; no son los precios mensuales de la tabla. Condiciones de Cloud.
En Serverless, escalar a cero reduce la espera pagada, pero arrancar y cargar el modelo también forman parte del tiempo facturable del trabajador. En Replicate, los modelos públicos por tiempo y los despliegues privados tienen reglas distintas: los privados suelen cobrar también preparación e inactividad mientras están en línea.
Centavos por hora: calcula el costo de lo que sí vas a usar
Con una A40 a US$0.59 por hora, una sesión de sesenta minutos representa US$0.59 de cómputo. Si hipotéticamente obtuvieras seis clips útiles, serían aproximadamente US$0.098 de cómputo por clip. Si sólo aprobaras uno, ese clip absorbería los US$0.59. No estamos afirmando que seis clips se produzcan en una hora: es una cuenta para planear, no una medición.
Después se suman los gastos que correspondan. Por ejemplo, reservar 100 GB de volumen de red en RunPod durante un mes completo a US$0.07/GB/mes da US$7 de almacenamiento, aunque generes poco. Incluye también las API adicionales, edición e impuestos aplicables; reparte esos gastos sobre las piezas finales. Tarifas de almacenamiento.
Calcula tu sesión
Para renta por tiempo. Incluye en los minutos todo el tiempo facturado: preparación con la GPU encendida, intentos, errores y espera. Los valores iniciales son un ejemplo hipotético.
Calcula en tu navegador. No reserva una GPU ni envía estos valores. Los cargos que no ingreses quedan fuera del total.
Registra también los descartes. Un clip terminado puede tener un error que lo vuelva inutilizable; esa ejecución sigue formando parte del presupuesto. Guarda la razón del rechazo para que el siguiente intento cambie algo concreto.
Descargar plantilla de registro (CSV)
Qué opción elegiría para empezar
Para aprender dirección y nodos sin administrar una máquina: Comfy Cloud, después de comprobar que el flujo y sus nodos están disponibles. Para controlar versiones, modelos y archivos: un Pod por sesión; Vast.ai también puede servir si comparas las condiciones de la oferta. Para pedir pocas piezas sin instalar: una API cuyo precio y parámetros encajen con la entrega. Para automatizar una producción repetida: evaluar Serverless una vez que el flujo ya funciona y tiene límites de costo.
La decisión práctica es ejecutar un piloto pequeño con criterios de aprobación y registrar tiempo total, fallas y salidas útiles. Compara proveedores con el mismo modelo, entradas y parámetros siempre que sea posible. Cambiar de modelo a mitad de la comparación impide saber qué mejoró.
Con Fer y los personajes rojos y azules conseguimos referencias, animaciones cortas y pruebas de luz útiles para explorar dirección. La continuidad de identidad, el contacto con objetos y la cámara siguen necesitando selección y corrección. El ahorro aparece cuando preparamos mejor cada intento y conservamos el aprendizaje de los que descartamos.
Preguntas frecuentes
¿Necesito una computadora potente?
Si el modelo se ejecuta en una GPU alquilada, tu equipo maneja el navegador, las transferencias y la revisión. Aun así necesitas conexión estable y espacio para respaldar resultados. La edición final puede exigir recursos locales según resolución y duración.
¿La GPU más barata siempre produce más barato?
No. Si no cabe el flujo, tarda mucho más o exige demasiada preparación, puede encarecer cada pieza útil. Mide el mismo trabajo y el porcentaje de resultados que apruebas.
¿Un LoRA funciona con cualquier modelo de video?
No debe asumirse. En Fer usamos el LoRA compatible con Z-Image para crear una imagen y después animamos esa referencia con Wan. Eso no trasladó los pesos del LoRA al modelo de video.
¿Puedo usar los resultados comercialmente?
Revisa las condiciones del modelo, los LoRAs y el servicio que uses, además de los permisos de las imágenes, personajes, música y referencias. Alquilar una GPU no concede por sí mismo derechos sobre esos materiales.
Dirección: David Rivera · investigación y documentación asistidas por Codex · más entradas